
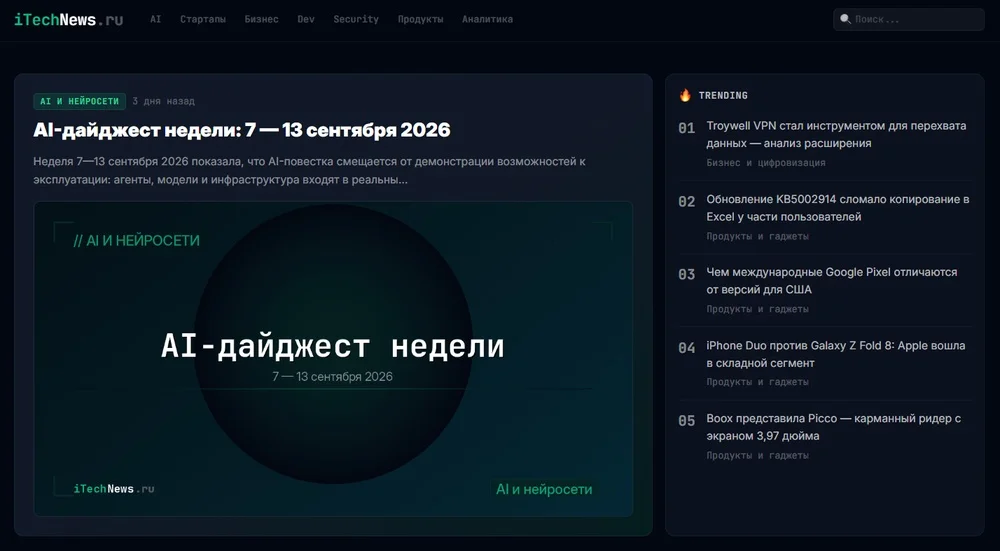
Привет! Я Егор Трушников, директор по развитию и стратегическим продуктам в Kokoc Group, резидент Нейроцеха. В начале 2026 года я в одиночку собрал iTech News: русскоязычный портал, который забирает IT-новости из англоязычных источников и переводит их на русский язык. На сайте уже больше 3000 страниц, из них 2000 попали в индекс Яндекса. За счет этого мы вышли на 6800 посетителей в месяц без платного продвижения.
Расскажу, как я разделил работу между пятью ИИ-ролями и заплатил всего $0,001 на одну новость. А еще почему до сих пор трачу по три часа в неделю на проверку текстов, дублей и ошибок в SEO.
Как я попробовал переводить новости сам и с нейронкой
Идея IT-портала давно казалась мне здравой. Я постоянно следил за новостями в сфере ИИ и безопасности, но большую часть материалов мне приходилось читать на английском — ведь в том же Reddit или в Hacker News информация появляется в разы быстрее. А до русскоязычной аудитории новости не всегда оперативно доходят, поэтому я решил переводить их и собирать на одном удобном сайте.
Я пытался переводить все сам вручную, но даже одна новость заняла у меня от 30 до 60 минут — это очень долго. За это время мне нужно было выполнить много действий: найти источник, перевести материал, выбрать категорию и теги, сверстать страницу в WordPress, подготовить описание для поиска. На этом задачка не заканчивалась, ведь еще предстояло опубликовать новость и анонс в Telegram.
Затем я выбрал самую короткую дорогу автоматизации: подключил RSS-ленты, передал материалы одной модели и попросил переписать их для русского IT-портала. 10 тестовых новостей хватило, чтобы увидеть проблему — модель теряла факты, добавляла суммы сделок, которых не было в оригинале. Она писала все материалы по одному шаблону, в итоге на выходе не было ни категорий, ни тегов, ни внятных заголовков под поисковые запросы.
Как я пришел к ИИ-редакции из 5 агентов
Когда я понял, что моя первая версия автоматизации провалилась, решил начать сначала и собрать архитектуру ИИ-конвейера. Для этого описал в отдельных файлах категории сайта, источники, тон текстов. Затем описал роли — инструкции для отдельных агентов, каждый из которых выполняет свою часть работы над новостями. В моем случае получилось 5 ролей:
- Сборщик. Определял тип новости, важность, тему, компании, продукты и технологии.
- Аналитик. Объединял события по темам и искал повторяющиеся сюжеты.
- Редактор. Писал новости и собирал из них статьи в еженедельном дайджесте.
- Шеф-редактор. На первом проходе убирал канцелярит, воду и пустые связки. На втором удалял один или несколько из 40 мертвых оборотов вроде «важно отметить» и «стоит сказать».
- Валидатор. Сверял результат с исходниками и переписывал слабые места.
Если бы по одному промпту ИИ одновременно собирала факты, писала, редактировала и проверяла, было бы непонятно, на каком шаге появилась ошибка. А такое разделение упрощало поиск проблем.
Важно было настроить роли так, чтобы каждый агент получал максимально точную и однозначную инструкцию. Например, мой сборщик отправлял аналитику не просьбу «проанализируй новости», а форму с точными полями:
| Аналитик itech-news.ru. Категория «{category_name}», период {week_label}. Для каждой статьи определи: summary (1-2 предл.), topic, entities (компании/продукты/технологии), type (release|investment|research|regulation|deployment|opensource|scandal|analytics|partnership|other), importance (High|Medium|Low). Верни JSON-массив: [{"id":N,"title":"...","url":"...","summary":"...","topic":"...", "entities":["..."],"type":"...","importance":"High|Medium|Low"}] | | :---- |
 В каких ИИ генерировать классные тексты
Первую рабочую версию сайта и конвейера я собрал за пару дней. И наконец-то вышла первая автопубликация! Можно сказать, что это очень быстро. Но на самом деле к тому моменту я уже год учился работать с Claude Code и Codex и даже собрал голосового бота для английского. Так что в этой разработке точно сыграл предыдущий опыт.
Как сменил три модели, чтобы новость стоила около $0,001
Первый рабочий конвейер я запустил на Claude Sonnet. Модель нормально справлялась с русским языком, фактами и структурой, но расходы на токены за первые сутки оказались слишком большими для проекта без дохода.
Я перевел все пять ролей на Claude Haiku. На тех же задачах он оказался в 12 раз дешевле Sonnet и давал приемлемый результат. Но для некоммерческого портала расход все равно был выше, чем мне хотелось.
Следующей моделью стала GPT-4o-mini. Здесь все пять ролей обходились примерно в $0,001 на одну новость. Дайджест из 30+ исходных материалов стоил около $0,02. Я не считал эти цифры полной ценой портала: в них нет моего времени или оплаты сервера. Это только расход на вызовы модели в рабочем конвейере.
Как научил систему отсеивать «умные матрасы»
Когда конвейер заработал, из RSS-лент пошли дубли, так как одна и та же публикация могла выйти в разных изданиях и уже быть на русском языке на другом сайте. Слова в заголовках были разные, но событие они отражали одно.
Чтобы исправить это, я собрал три уровня дедупликации, где проверка идет от дешевой к более сложной. Система:
- Сравнивала точные адреса. Если такая ссылка уже была, материал отбрасывался.
- Сравнивала заголовки.
- Брала значимые слова из заголовков и оценивала их пересечение. Если совпало больше половины, материал считался дублем. Большинство повторов отсеивалось до этой более дорогой обработки.
Другая проблема оказалась повеселее. В новостные ленты попадали «лучшие умные матрасы 2026», карьерные рефлексии и списки советов для подростков. Были и ложные совпадения, например опреснение морской воды проходило по слову technology.
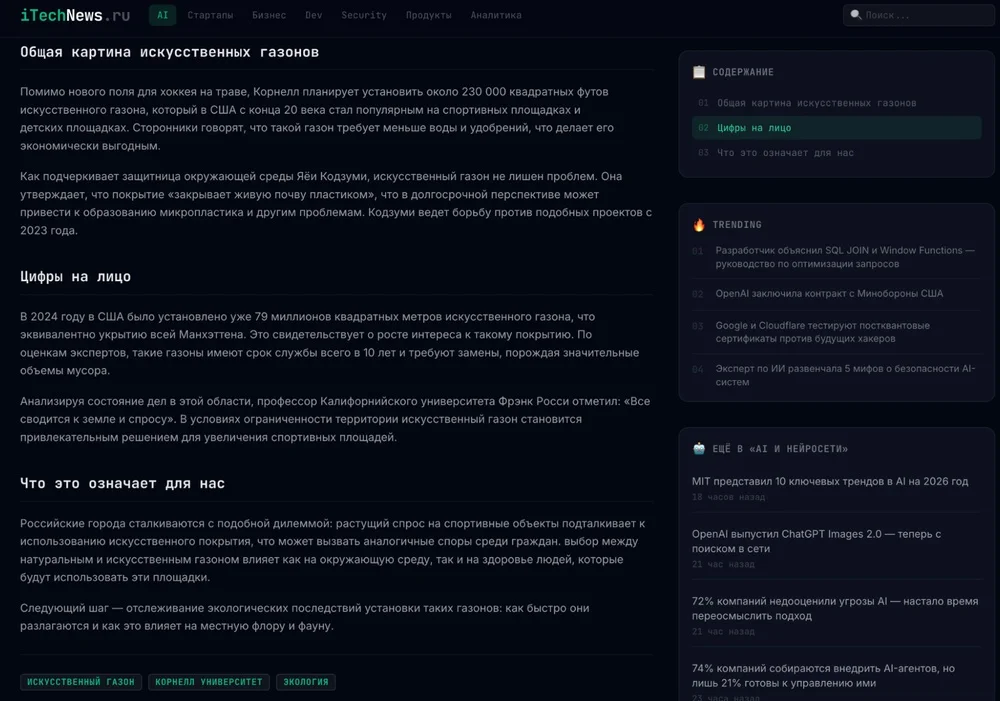
Для решения этой проблемы я собрал два списка регулярных выражений, чтобы один отсеивал полные заголовки вроде «Who is hiring». А второй искал фрагменты, которые выдают личную историю, список советов или потребительскую подборку. Когда появлялась новая категория мусора, я добавлял в нужный список один шаблон. В следующие прогоны система отбрасывала похожие материалы до обработки.
Я каждую неделю ищу новые ошибки
 Как оплачивать зарубежные нейросети из России и забыть про расстояние
Агенты уменьшили число проблем, но не убрали их. Редактор все еще может дописать сумму сделки или фамилию руководителя, которых не было в исходнике. Валидатор сверяет текст с оригиналом и вырезает такие детали, но иногда они доходят до публикации. Отдельные ошибки всплывают в SEO. Мой скрипт находит такие случаи, но решение по каждому из них я все еще принимаю сам.
Раз в неделю я пробегаю заголовки глазами, проверяю отчет SEO-аудита и дописываю фильтры. Все вместе занимает около 2–3 часов. Эта проверка нужна еще и потому, что одну неделю ChatGPT стабильно отсеивает мусор, а затем без видимой причины пропускает то, что раньше ловила.
Я довел портал до 6800 посетителей, но пока на нем не зарабатываю
Сейчас на сайте около 3000 страниц, 2000 из них уже в индексе Яндекса. Портал посещают около 6800 человек в месяц или в среднем 200–300 читателей в день. Новости выходят ежедневно, а по понедельникам я выпускаю большой ИИ-дайджест. Все это работает без платного продвижения, но дохода проект пока не приносит.
Следующий шаг — дорастить трафик до уровня полноценного новостного портала, а потом продавать рекламные места и продвигать через сайт собственные IT-проекты.
Чтобы не потеряться в тысячах инструментов, заглядывайте в наш список проверенных сервисов с ИИшками.
Список обновляем постоянно.