Fine-tuning или дообучение — это процесс, при котором обученную нейросеть адаптируют под конкретную задачу с помощью дополнительных данных. Благодаря этому модель может лучше справляться с узкоспециализированными задачами. Например, отвечать на вопросы клиентов в стиле конкретной компании, анализировать профильные документы или распознавать специфические объекты на фото. И это лишь некоторые из возможных сценариев.
Разбираем в статье, как работает fine-tuning и где он применяется.
Как работает дообучение модели
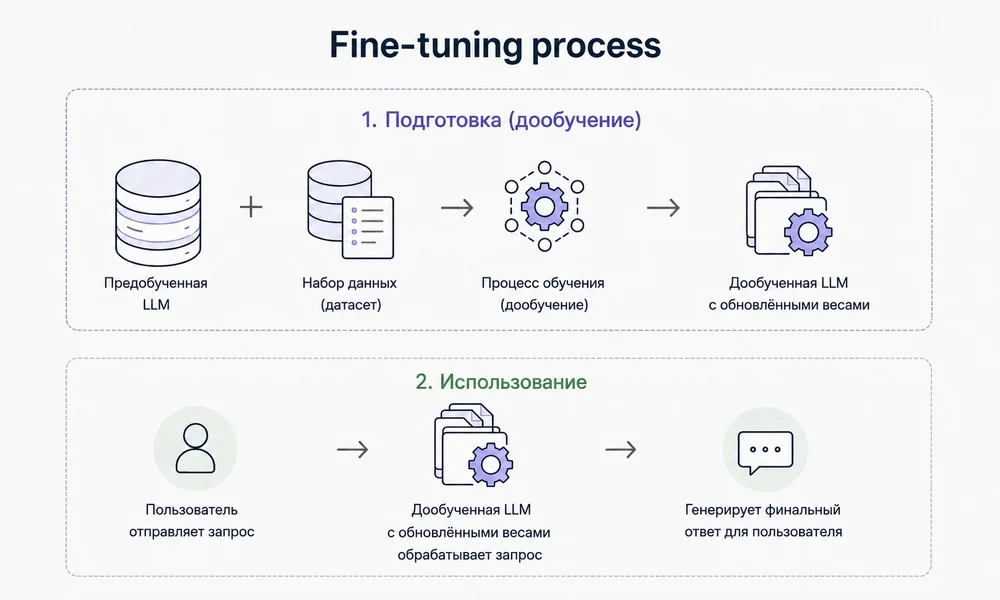
В основе fine-tuning лежит принцип переиспользования знаний, полученных при базовом обучении. Модель уже умеет распознавать закономерности, например, понимать структуру языка, различать объекты на изображениях, улавливать связи между словами. Поэтому при дообучении модель не учат заново — ее знания корректируют под новую задачу.
Во многом дообучение похоже на введение в должность нового сотрудника. Человек уже умеет работать в профессии, но в новой компании ему объясняют внутренние правила, принятые форматы документов и стиль общения. С моделью происходит примерно то же самое. Она уже умеет работать с языком или изображениями в целом, но дообучение помогает точнее настроить это умение под конкретную задачу.
 «Сделаемская школа»: как мы выпускаем курсы с нейросетью и экономим 300 000 рублей
На практике это выглядит так: модели показывают много примеров правильной работы, обычно в виде пары «запрос — ответ»: задачи и образцового результата. Например, для дообучения чат-бота поддержки используют реальные вопросы клиентов вместе с удачными ответами операторов, а для генерации описаний — карточки товаров, оформленные по нужному шаблону. Разбирая сотни таких пар, модель улавливает закономерность: какой ответ в этой задаче считается правильным и как он должен выглядеть. После этого она может сама составлять ответы на новые запросы, которых не было в примерах.
Качество работы зависит не от самой технологии, а от примеров, на которых училась модель. Если в данных есть ошибки или противоречия, модель примет их за образец и будет повторять в своей выдаче. Если же примеры качественные и отражают реальную задачу, модель будет отвечать точнее и стабильнее.
Дообучение требуется далеко не во всех случаях. Если автору нужно, чтобы модель иногда писала тексты в определенном стиле или генерировала изображения в нужной манере, то заморачиваться обычно не стоит. Достаточно собрать несколько удачных примеров, приложить их к запросу, и модель сгенерирует нужный результат с учетом собранного контекста.
Дообучать модель лучше в тех случаях, когда компании нужно собственное решение. Например, чат-бот поддержки, который будет ориентироваться в большой базе знаний и отвечать на вопросы пользователей в определенном стиле. Но готовое решение под ключ может обойтись в сотни тысяч рублей и выше. Это связано с тем, что для дообучения нужны качественные данные в формате «запрос — ответ», вычислительные мощности и специалисты, которые подготовят данные и запустят процесс. Поэтому прежде чем браться за дообучение, имеет смысл прикинуть, не решается ли задача более простыми способами.
Методы дообучения
Полное дообучение. Это вариант, при котором во время обучения обновляют всю модель целиком: показывают новые примеры и корректируют параметры (внутренние настройки модели), чтобы она лучше решала нужную задачу. Такой способ используют, когда есть большой объем качественных данных, вычислительных ресурсов и памяти.
Параметрически-эффективное дообучение или PEFT. Это группа методов, при которых меняют только небольшую часть параметров, а другие оставляют без изменений. Точность получается близкой к полному дообучению, но решение обходится в разы дешевле и исходные знания модели сохраняются лучше.
Внутри PEFT есть несколько методов:
- LoRA. Вместо того чтобы менять всю модель, к готовой основе добавляют небольшие обучаемые блоки — они как сменные детали, адаптированные под свою задачу. Благодаря этому требуется меньше памяти, и настройка проходит проще. Это удобно, когда большую модель нужно быстро настроить под конкретную задачу: под ответы службы поддержки, разметку отзывов, генерацию текстов в нужной манере или работу с изображениями.
К примеру, когда пользователь загружает картинки в Telegram-бот, модель обучается на их основе и генерирует нужный контент. При этом сама модель уже умеет создавать качественные изображения людей, но LoRA подсказывает ей, как выглядит конкретный человек. В результате получаются новые фото с его лицом в любых образах и обстановках.
- QLoRA. Это облегченная версия LoRA: основную модель сжимают, чтобы она занимала меньше памяти, затем обучают только небольшие дополнительные блоки. При этом методе дообучения немного теряется точность ответов, но модель работает по-прежнему быстро.
Например, благодаря QLoRA некоторые большие языковые модели можно дообучить на одной видеокарте обычного компьютера, тогда как для обычной LoRA понадобился бы мощный сервер.
- Дообучение через подсказки (soft prompts). Саму модель вообще не меняют — к запросу добавляют специальные настраиваемые «подсказки», которые направляют ответы в нужную сторону. Но не стоит путать их с промптами — обычными ручными инструкциями пользователя.
С помощью этих подсказок модель можно приучить всегда отвечать коротко и в деловом тоне, не переписывая инструкцию заново при каждом запросе. Это самый доступный способ по ресурсам, но возможности у него ограничены в сравнении с LoRA и QLoRA.
Выбор метода зависит от задачи и ресурсов: если нужна максимальная точность ответов и есть мощное оборудование, то подойдет полное дообучение. А в большинстве остальных случаев выгоднее использовать экономичные методы вроде LoRA и QLoRA.
В чем разница между промптингом, базой знаний и fine-tuning
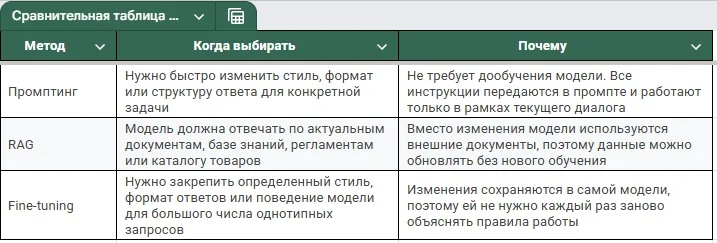
Промптинг — самый простой и быстрый способ повлиять на ответ. Пользователь может написать инструкции прямо в запросе, задать модели роль, формат, примеры и ограничения. Нейросеть при этом не переучивается и не получает доступа к новым данным, а адаптируется к задаче за счет контекста текущего диалога. Поэтому промптинг обычно используют, когда нужны небольшие корректировки: изменить стиль ответа, поменять структуру текста или порядок действий.
База знаний (RAG) работает по другой логике. Модель не просят отвечать только по памяти, ей передают фрагменты нужных документов перед генерацией ответа. Это может быть база знаний компании, внутренние инструкции, каталог товаров или справочные материалы. Благодаря этому модель отвечает, опираясь на загруженные документы, а не только на то, что усвоила при обучении. Такой подход особенно полезен, когда информация часто меняется, например, если обновился регламент или появились новые данные. В этом случае достаточно заменить документы в базе, а не настраивать модель заново.
Fine-tuning — более основательный способ повлиять на модель. Если промптинг действует только в рамках одного диалога, то при дообучении меняется сама модель: ей показывают новые примеры и корректируют ее внутренние настройки — веса. Поэтому изменения не исчезают после ответа, а закрепляются в модели. Она запоминает новые шаблоны и дальше применяет их сама, так что прописывать инструкции вручную при каждом запросе уже не нужно. Такой подход используют, когда одного промптинга или связки с RAG уже не хватает и нужно изменить само поведение модели: закрепить определенный стиль, адаптировать ответы под узкую предметную область или под задачи, которые сложно описать одним промптом.
Выбор метода адаптации модели обычно зависит от самой задачи. Когда хватает точной инструкции и пары примеров, можно обойтись промптингом. В ситуациях, где модели нужны свежие факты, регламенты или другие документы, чаще используют RAG. Fine-tuning стоит использовать, когда есть повторяющаяся задача и от модели требуется максимально стабильный результат по форме, тону и логике ответа. Эти подходы не исключают друг друга, и в рабочих сценариях их нередко комбинируют.
Где используется fine-tuning
Чат-боты для поддержки клиентов. Дообученные модели могут отвечать на вопросы в фирменном тоне бренда и придерживаться принятых в компании стандартов общения: выдерживать нужную манеру, структуру ответа и уровень формальности. Например, одинаково вежливо реагировать на типовые обращения по доставке, оплате или возврату и оформлять ответ по единому образцу. Чтобы бот опирался на актуальные сведения о компании, дообучение обычно дополняют RAG: так модель отвечает не по памяти, а на основе свежих документов. Всё это позволяет закрыть заметную часть типовых обращений без участия живого оператора.
Генерация контента под бренд. Компании дообучают языковые модели на своих текстах, чтобы те составляли описания товаров, рассылки и посты в едином стиле. Например, модель можно адаптировать под определенный тон: дружелюбный и неформальный для соцсетей или более сдержанный для договоров и официальных писем. Это ускоряет подготовку материалов и помогает сохранить узнаваемый голос бренда.
Работа с отраслевыми документами. В медицине, юриспруденции и финансах много специфических терминов и форматов, которые базовая модель понимает поверхностно. После дообучения на профильных текстах модель может точнее анализировать договоры, медицинские заключения или финансовые отчеты. Например, юридическая фирма может адаптировать модель, чтобы она помогала в первичном разборе типовых договоров: отмечала необычные условия и спорные формулировки.
Распознавание специфических объектов. Готовые модели хорошо различают повседневные предметы, но могут чаще ошибаться в узкоспециализированных задачах. После дообучения модель учится распознавать то, чего не было в исходных данных. Например, в сельском хозяйстве модели дообучают определять болезни растений по фотографиям листьев, а в производстве — находить дефекты деталей.
Общение в стиле компании. Бизнес может дообучать модель на собственных правилах общения с клиентами, чтобы она вела диалог в нужной манере и учитывала контекст компании. Например, можно так настроить модель ассистента, чтобы она отвечала на вопросы о товарах в фирменном стиле, уместно предлагала сопутствующие позиции и выдерживала тон, принятый в коммуникации с покупателями.
Коротко о главном
Дообучение модели — это способ подстроить уже обученную нейросеть под конкретную задачу. Для этого нейросети нужно показать примеры правильных результатов, чтобы она усвоила логику и нужный формат ответа.
Дообучение пригодится в поддержке клиентов, персонализации общения, работе с документами, генерации текстов и распознавании изображений. Но если модели часто нужны обновленные данные, то удобнее подключить внешний источник через RAG, не меняя внутренние настройки модели. О том, в каких случаях выбрать промптинг, RAG или fine-tuning — сделали сравнительную таблицу в Google Sheets.
Как «Норникель» первым в России испытывает автономную технику под землей и причем тут ИИ.